谷歌大脑最新操作玩“复古”:不用卷积注意力,图像分类接近SOTA
本文经AI新媒体量子位(公众号ID:QbitAI)授权转载,转谷歌载请联系出处。
谷歌大脑的视觉Transformer团队(ViT),搞了个大脑复古操作。
他们不用卷积神经网络(CNN)、也不用Transfor最新mer,仅凭最早的AI视觉任务采用的多层感知机(MLP)结构,就实现操作了接近SOTA的性能,更是在ImageNet图像分类任务上取得了玩“87.94%的准确率。
这个架构名为MLP-Mixer,采用两种不同类型的复古MLP层,可以看做是一个特殊的CNN,使用 1×1卷积进行通道混合(按位操”:作),同时全感受野和参数共享的的单通道深度卷积进行字符混合(跨位操不用作)。
在JFT-300M数据集上预训练、微调到224分辨率的Mix卷积er-H/14版本取得了86.32%的准确率,比SOTA模型Vi注意T-H/14仅低0.3%,但运行速度是其2.2倍。
论文地址:
ht力,tps://arxiv.org/abs/2105.01601
项目地址:
h图像ttps://github.com/google-research/分类vision_transformer/tree/linen
&nbs接近p;
(责任编辑:清洁用品)
 京东云联合京东物流等打造“京东冷链溯源平台” 服务400万件生鲜商品
 谷歌确认Gemini赋能新版Siri:苹果情境感知功能定档2026年发布
 iOS26.1Beta3暗示“苹果智能”将集成谷歌Gemini等更多第三方AI模型
 标签: 西部数据 WD 机械硬盘 AI基础设施
 标签: 字节跳动 ByteClaw OpenClaw 安全规范
-
标签: Meta Limitless Rewind Mac AI穿戴设备
 云梦级12月6日云梦级消息,据科技媒体 9to5Mac 报道, Meta 公司宣布收购 AI 初创公司 Limitless(前身为 Rewind AI),其核心产品 Rewind Mac 应用将于 1...[详细]
-
“英特尔侵犯芯片专利被判赔22亿美元”上热搜 网友:国内该学习
 新浪科技讯 3月3日上午消息,#英特尔侵犯芯片专利被判赔22亿美元#登上微博热搜,知识产权问题再次引发网友关注。 据报道,3月2日,美国得克萨斯州一家联邦法庭裁决,英特尔公司侵犯他人半导体制造专利,需...[详细]
-
标签: 商汤科技 SenseNova U1 NEO-unify 多模态模型
 云梦级4月29日云梦级消息,商汤科技正式发布并开源商汤日日新SenseNova U1 系列原生理解生成统一模型。它基于商汤于今年三月份自主研发的 NEO-unify架构,在单一模型架构上统一了多模态理...[详细]
-
标签: 工业富联 AI_GPU机柜 800G交换机 CPO交换机
 云梦级4月28日云梦级消息,4月28日晚间,工业富联(601138)发布2026年一季报显示,公司一季度实现归属净利润约为105.95亿元,同比增长102.55%。 财报显示,2026年一季度,工业富...[详细]
-
华人博士生首次尝试用两个Transformer构建一个GAN
 最近,CV 研究者对 transformer 产生了极大的兴趣并取得了不少突破。这表明,transformer 有可能成为计算机视觉任务(如分类、检测和分割)的强大通用模型。 我们都很好奇:在计算机视...[详细]
-
苹果发布M5芯片MacBook Pro:首款AI优化Mac处理器,续航达24小时
 苹果公司近日推出搭载M5芯片的14英寸MacBook Pro新品。这是苹果首款专门针对AI任务进行硬件优化的Mac处理器,将本地AI计算能力作为核心卖点,并实现了24小时的电池续航时长。 M5芯片采用...[详细]
-
 近日,美国民主党联邦参议员丽莎白沃伦在盛顿的一活动中发警告,表示 AI 行业正面临着类似于 2008 年金融危机的风险。沃伦指出,AI 行业的快速发展和大量资金的投入可能导致泡沫的形成,威胁到整个金融...[详细]
-
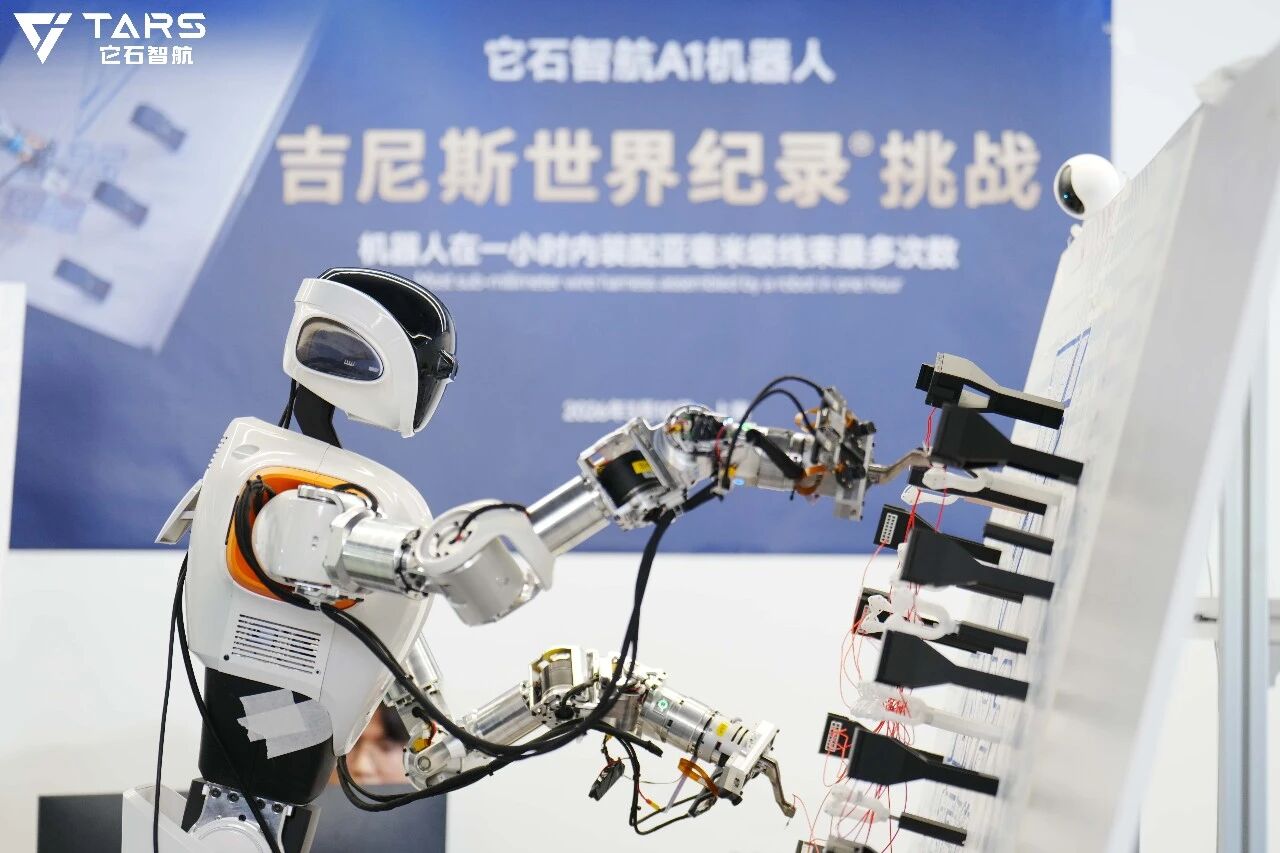 云梦级4月16日云梦级消息,4月16日,它石智航宣布完成4.55亿美金Pre-A轮融资,创下中国具身智能有史以来最高单轮融资纪录和最大Pre-A轮融资纪录。 财务投资者层面,高瓴创投,与红杉中国本次联...[详细]
-
IBM 发布 Granite 4.0 Nano 模型,突破小型 AI 模型的性能极限
 近日,IBM 推出了四款新的 Granite4.0Nano 模型,这一系列模型的参数规模从350万到15亿不等,展示了公司在人工智能领域对高效与可及性的重视。与行业中大型模型普遍依赖云计算的趋势不同,...[详细]
-
标签: 微软 Azure Microsoft 365 Copilot
 云梦级10月30日云梦级消息,微软 2026 财年首个财季(对应 2025 年第三季度)表现亮眼。今天公布的财报数据显示,微软该季度营收达 776.73 亿美元(现汇率约合 5513.73 亿元人民币...[详细]