告别「复制+粘贴」,基于深度学习的OCR,实现PDF转文本
传统的讲座通常伴随着一组 pdf 幻灯片。一般来说,想要对此类讲座做笔记,需要从 pdf 复制、粘贴很多内容。
最近,来自 K1 Digital 的高级机器学习工程师 Lucas Soares 一直在尝试通过使用 OCR(光学字符识别)自动转录 pdf 幻灯片,以便直接在 markdown 文件中操作它们的内容,从而避免手动复制和粘贴 pdf 内容,实现这一过程的自动化。
左为项目作者 Lucas Soares。
项目地址:https://github.com/EnkrateiaLucca/ocr_for_transcribing_pdf_slides
为什么不使用传统的 pdf 转文本工具呢?
Lucas Soares 发现传统工具往往会带来更多的问题,需要告别花时间解决。他曾经尝试使用传统的 Python 软件包,但是遇到了很多问题(例如必须使用复杂的正则表达式模式解析最终输出等),因此决定尝试使用目标检测和 OCR 来解决。
基本过程可分为以下步骤:
将 pdf 转换为图片; 检测和识别图像中的文本; 展示示例输出。
基于深度学习的 OCR 将 pdf 转录为文本
将 pdf 转换为图像
Soares 使用的 pdf 幻灯片来自于 David Silver 的增强学习(参见以下 pdf 幻灯片地址)。使用「pdf2image」包将每张幻灯片转换为 png 图像格式。
pdf 幻灯片示例。
地址:https://www.davidsilver.uk/wp-content/uploads/2020/03/intro_R「复L.pdf
代码如下:
from pdf2image import convert_from_path from pdf2image.exceptions import ( PDFInfoNotInstalledError, PDFPageCountError, PDFSyntaxError ) pdf_path = "path/to/file/intro_RL_Lecture1.pdf" images制+ = convert_from_path(pdf_path) for i, image in enumerate(images): fname = "image" + str(i) + ".png" image.save(fname, "PNG")
经过处理后,所有的 pdf 幻灯片都转换成 png 格式的图像:
检测和识别图像中的文本
为了检测和识别 png粘贴 图像中的文本,Soares 使用 ocr.pytorch 库中的文本检测器。按照说明下载模型并将模型保存在 checkpoints 文件夹中。
ocr.pytorch 库地址:https://github.com/courao/ocr.pytorch
代码如下:
# adapted from this source: https://github.com/courao/ocr.pytorch %load_ext autoreload %autoreload 2 import os from&nb」,sp;ocr import ocr import time import shutil import numpy as np import pathlib from PIL import Image from glob import glob import matplotlib.pyplot as plt import seaborn as基于 sns sns.set() import pytesseract def single_pic_proc(image_file): image = np.array(Image.open(image_file).convert('RGB')) result, image_framed = ocr(image) re深度turn result,image_framed image_files = glob('./input_images/*.*') result_dir = './output_images_with_boxes/' # If the output folder exists we will remove it and redo it. if os.path.exi学习sts(result_dir): shutil.rmtree(result_dir) os.mkdir(result_dir) for image_file in sorted(image_files): result, image_framed = single_pic_proc(image_file) # detecting and recognizing&的Onbsp;the text filename = pathlib.Path(image_file).name output_file = os.path.join(result_dir, image_file.split('/')[-1]) txt_file = os.path.join(result_dir, image_file.split('/')[CR-1].split('.')[0]+'.txt') txt_f = open(txt_file, 'w') Image.fromarray(image_framed).save(output_file) for key in result: txt_f.write(result[,实key][1]+' ') txt_f.close()
设置输入和输出文件夹,接着遍历所有输入图像(转换后的 pdf 幻灯片),然后通过 single_pic_proc() 函数运行 OCR 模块中的检测和识别模型,最后将输出保存到输出文件夹。
其中检测继承(inherit)了 Pytorch CTPN 模型,识别继承了 Pytorch CRNN 模型,两者都存在于 OCR 模块中。
示例输出
代码如下:
import cv2 as cv output_dir = pathlib.Path("./outp现Put_images_with_boxes") # image = cv.imread(str(np.random.choice(list(output_dir.iterdir()),1)[0])) image = cv.imread(f"{output_dir}/image7.png") size_reshaped = (int(image.shape[1]),int(image.shape[0])) image = cv.resize(image, siDFze_reshaped) cv.imshow("image", image) cv.waitKey(0) cv.destroyAllWindows()
下图左为原始 pdf 幻灯片,图右为转录后的输出文本,转录后的准确率非常高。
文本识别输出如下:
filename = f"{output_dir}/image7.txt" with open(filename, "r") as text: for line&nbs转文p;in text.readlines(): print(line.strip(" "))
通过上述方法,最终你可以得到一个非常强大的工具来转录各种文档,从检测和识别手写笔记到检测和识别照片中的随机文本。拥有自己的 OCR 工具来处理一些文本内容,这比依赖外部软件来转录文档要好的多。
(责任编辑:在线下单)
 一篇关于HDFS的快照讲解
 OpenAI年收入130亿美元,但承诺十年投入万亿:五年内需完成商业模式验证
 苹果或重振10亿美元爱尔兰数据中心:申请延长规划许可
 标签: Lululemon Calvin McDonald 第三季度财报 CEO卸任
 机器学习让骨科图像分析更进一步
-
 云梦级3月6日云梦级消息,诺因(KNOWIN)正式宣布完成天使+轮融资,本轮融资由钟鼎资本投资,光源资本担任独家财务顾问,投后估值超20亿元人民币。 自2025年7月成立以来,诺因在小半年内已连续完成...[详细]
-
 Hello,大家早上好,又是元气满满的一天,先来浏览新鲜的早报吧~ 【雷军称小米YU7 GT有点小贵】 小米 YU7 GT 即将发布,雷军称其为时代精英打造。新车搭载新一代超级电机 V8s EVO,最...[详细]
-
 随着AI(人工智能)的进一步发展,具有更多新用途和益处的巨大潜力,并且这些服务将进一步推动视频监控市场的成熟。它已经使高度定制化的视频监控服务更加便宜,因为一个运营商现在可以比以前监视更多的站点。 由...[详细]
-
 据报道,亚马逊今年6月收购的无人驾驶初创公司Zoox发布了一款全自动电动汽车,该汽车没有方向盘,可坐4名乘客,最高时速达75英里/小时,最长可行驶16小时。该公司将在一些美国城市推出叫车服务,包括旧金...[详细]
-
谷歌推出AI营销工具Pomelli:只需网址即可自动化生成品牌内容
 谷歌近日发布了一款名为Pomelli的AI驱动营销自动化工具,旨在帮助用户通过简单输入网站地址,即可快速生成定制化营销内容。该工具标志着AI在数字营销领域的又一创新应用,尤其针对资源有限的中小企业和初...[详细]
-
 根据最新民调显示,半数英国成年人对人工智能(AI)将如何影响他们的工作感到担忧。这项由工会组织工人联合会(TUC)进行的调查结果显示,2600名受访者中有51% 的人表示,他们对 AI 可能导致的工作...[详细]
-
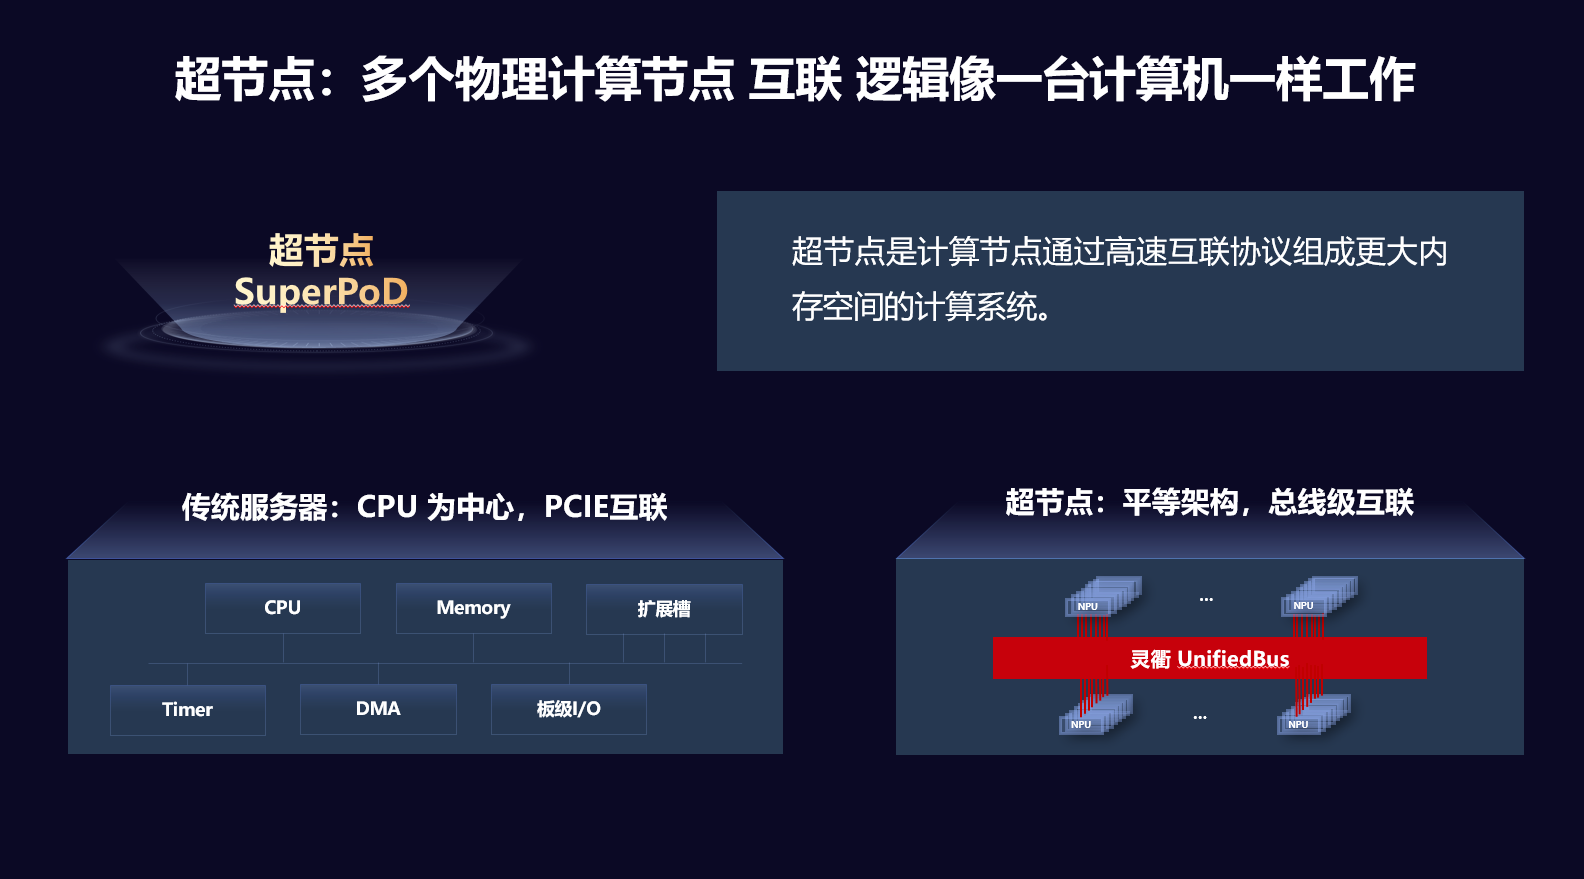 AI像火焰,正在吞噬世界,而算力构成了“柴薪”。在国与国之间的人工智能竞争日益激烈的当下,算力成为国力的重要体现。 围绕着这个话题,不久前,华为在北京组织了2026新春媒体沙龙。目前,计算产业已经成为...[详细]
-
 云梦级2月27日云梦级消息,据华尔街见闻报道,寒武纪2月28日晚间披露2025年度业绩快报。数据显示,公司全年实现营业收入64.97亿元,同比增长453.21%;归母净利润为20.59亿元,相较上年同...[详细]
-
《Kubernetes》,你需要掌握的 Service 和 Ingress
 k8s 我们已经从 NameSpace、Pod、PodController到Volumn都介绍过了,相信看完的小伙伴们也会很有收获的~那么今天我们继续来到k8s的课堂,这节我们将要来说下 k8S 搭建...[详细]
-
 云梦级6月21日云梦级消息,据第一财经报道,6月21日举办的2026年APEC工商领导人中国论坛上,京东集团创始人、董事局主席刘强东透露,近期,京东内部提出了“涅槃计划”,希望把京东已有的70万快递员...[详细]