一张图,详解大数据技术架构
开局一张图:
这是某公司使用的大数据平台架构图,大部分公司应该都差不多。
从这张大数据的整体架构图上看来,大数据的核心层应该是:数据采集层、数据存储与分析层、数据共享层、数据应用层,可能叫法有所不同,本质上的角色都大同小异。
所以我下面就按这张架构图上的线索,慢慢来剖析一下,大数据的核心技术都包括什么。
—01—. 大数据采集
数据一张采集的任务就是把数据从各种数据源中采集和存储到数据存储上,期间有可能会做一些简单的清洗。
数据源的种类比较多:
1、网站日志
作为互联网行业,网站日志占的份额最大,网站日志存储在多台网站日志服务器上,一般是在每台网站日志服务器上部署flume agent,实时的收集网站日志并存储到HDFS上。
2、业务数据库
业务数据库的种类也是多种多样,有M图,ysql、Oracle、SqlServer等,这时候,我们迫切的需要一种能从各种数据库中将数据同步到HDFS上的工具,Sqoop是一种,但是Sqoop太过繁重,而且不管数据量大小,都需要启动MapReduce来执行,而且需要Hadoop集群的每台机器都能访问业务数据库;应对此场景,淘宝开源的DataX,是一个很好的解决方案,有资源的话,详解可以基于DataX之上做二次开发,就能非常好的解决。
当然,Flume通过配置与开发,也可以实时的从数据库中同步数据到HDFS。
3、来自于Ftp/Http的数据源
有可能一些合作伙伴提供的数据,需要通过Ftp/Http等定时获取,DataX也可以满足该需求。
4、其他数据源
比如一些手工录入的数据,只需要提供一个接口或小程序,即可完成。
—02—.大数 大数据存储与分析
毋庸置疑,HDFS是大数据环境下数据仓库/数据平台最完美的数据存储解决方案。
离线数据分析与计算,也就是对实时性要求不高的部分,在笔者看来,Hive还是首当其冲的选择,丰富的数据类型、内置函数;压缩比非常高的ORC文件存储格式;非常方便的SQL支持,使得Hive在基于结构化数据上的统计分析远远比MapReduce要高效的多,一据技句SQL可以完成的需求,开发MR可能需要上百行代码;
当然,使用Hadoop框架自然而然也提供了MapReduce接口,如果真的很乐意开发Java,或者对SQL不熟,那么也可以使用MapReduce来做分析与计算;
Spark是这两年非常火的,经过实践,它的性能的确比MapReduce要好很多,而且和Hive、Yarn结合的越来越好,因此术架,必须支持使用Spark和SparkSQL来做分析和计算。因为已经有Hadoop Yarn,使用Spark其实是非常容易的,不用单独部署Spark集群。
—03—. 大数据共享
这里的数据共享,其实指的是前面数据分析与计算后的结果存放的地方,其实就是关系型数据库和NOSQL数据库;
前面使用Hive、MR、Spark、SparkSQL分析和计算的结果,一张还是在HDFS上,但大多业务和应用不可能直接从HDFS上获取数据,那么就需要一个数据共享的地方,使得各业务和产品能方便的获取数据;和数据采集层到HDFS刚好相反,这里需要一个从HDFS将数据同步至其他目标数据源的工具,同样,DataX也可以满足。
另外,一些实时计算的结果数据可能由实时计算模块直接写入数据共享。
—04—. 大数据应用 1、业图,务产品(CRM、ERP等)
业务产品所使用的数据,已经存在于数据共享层,直接从数据共享层访问即可;
2、报表(FineReport、业务报表)
同业务产品,报表所使用的数据,一般也是已经统计汇总好的,存放于数据共享层;
3、即席查询
即席查询的用户有很多,有可能是数据开发人员、网站和产品运营人员、数据分析人员、甚至是部门老大,他们都有即席查询数据的详解需求;
这种即席查询通常是现有的报表和数据共享层的数据并不能满足他们的需求,需要从数据存储层直接查询。
即席查询一般是通过SQL完成,最大的难度在于响应速度上,使用Hive有点慢,可以用SparkSQL,它的响应速度较Hive快很多,而且能很好的与Hive兼容。
当然,你也可以使用Impala,如果不在乎平台中再多一个框架的话。
4、OLAP
目大数前,很多的OLAP工具不能很好的支持从HDFS上直接获取数据,都是通过将需要的数据同步到关系型数据库中做OLAP,但如果数据量巨大的话,关系型数据库显然不行;
这时候,需要做相应的开发,从HDFS或者HBase中获取数据,完成OLAP的功能;比如:根据用户在界面上选择的不定的维度和指标,通过开发接口,从HBase中获取数据来展示。
5、其它数据据技接口
这种接口有通用的,有定制的。比如:一个从Redis中获取用户属性的接口是通用的,所有的业务都可以调用这个接口来获取用户属性。
—05—. 实时数据计算
现在业务对数据仓库实时性的需求越来越多,比如:实时的了解网站的整体流量;实时的获取一个广告的曝光和点击;在海量数据下,依靠传统数据库和传统实现方法基本完成不了,需要的是一种分布式的、高吞吐量的、术架延时低的、高可靠的实时计算框架;Storm在这块是比较成熟了,但我选择Spark Streaming,原因很简单,不想多引入一个框架到平台中,另外,Spark Streaming比Storm延时性高那么一点点,那对于我们的需要可以忽略。
我们目前使用Spark Streaming实现了实时的网站流量统计、实时的广告效果统计两块功能。
做法也很简单,由一张Flume在前端日志服务器上收集网站日志和广告日志,实时的发送给Spark Streaming,由Spark Streaming完成统计,将数据存储至Redis,业务通过访问Redis实时获取。
—06—. 任务调度与监控
在数据仓库/数据平台中,有各种各样非常多的程序和任务,比如:数据采集任务、数据同步任务、数据分析任务等;
这些任务除了定时调度图,,还存在非常复杂的任务依赖关系,比如:数据分析任务必须等相应的数据采集任务完成后才能开始;数据同步任务需要等数据分析任务完成后才能开始;
这就需要一个非常完善的任务调度与监控系统,它作为数据仓库/数据平台的中枢,负责调度和监控所有任务的分配与运行。
(责任编辑:公司治理)
 告别“独占”时代:OpenAI 与微软达成新协议,重塑 AI 权力版图
 Google BigQuery是大数据分析的未来吗?
 比尔·盖茨首次在Clubhouse“开房”:平时常用手机并非苹果制造
 涓滀含濂ヨ繍浼氭槑鏃ュ紑骞曪紒闃块噷浜戞敮鎾戦�娆′簯涓婄洿鎾�
 马斯克旗下 xAI 发布 Grok 4 Fast:速度提升十倍但细节有所妥协
-
三星官宣AI眼镜战略:2026年首发,2027年上AR屏,联手谷歌与时尚巨头重塑可穿戴未来
 科技与时尚的边界正在被一副眼镜悄然打破。三星近日正式公布其AI眼镜战略,宣布将携手谷歌以及两大眼镜品牌Gentle Monster和Warby Parker,共同打造新一代智能可穿戴设备。这款尚未命名...[详细]
-
 3月5日消息,日前,“加快数智乡村建设 激活乡村振兴新动能”座谈会正式举办 政协委员、数智乡村领域专家以及企业代表齐聚一堂,聚焦数智乡村建设实践、乡村振兴新动能等话题进行了深入交流、探讨,并为数智乡村...[详细]
-
 在 2025 腾讯全球数字生态大会上,深圳热闹非凡,来自各方的科技爱好者汇聚一堂,共同见证腾讯在人工智能领域的新突破。会上,腾讯正式推出了全新大模型 —— 混元 3D 3.0。这款模型在 3D 建模领...[详细]
-
 云梦级2月28日云梦级消息,领英最新发布的《2026全球劳动力市场洞察报告》显示,过去两年AI创造的岗位数量(至少130万个)实际上多于其取代的岗位。 诸如,“前端部署工程师”“AI工程师”这类在五年...[详细]
-
 云梦级4月1日云梦级消息,京东方 A 31日晚发布 2025 年年度报告。财报显示,2025 年公司实现营业收入约 2045.90 亿元,同比增长 3.13%;归属于上市公司股东的净利润约为 58.5...[详细]
-
 【#苹果最新季度销售将首次破1000亿美元#】据报道,华尔街分析师预计,在最新一季的财报中,苹果公司营收或将首次突破1000亿美元。27位分析师通过雅虎财经预测,在截至12月31日的2021年第一财季...[详细]
-
3000亿美元天价合同震撼硅谷!OpenAI牵手Oracle,五年云计算超级协议重塑AI格局
 硅谷的夜空被一笔史无前例的巨额交易点亮了。Oracle公司的股价在昨日收盘后如火箭般冲天而起,背后的推手正是该公司宣布与多家客户签署了数十亿美元级别的重磅合同。而现在,这些神秘客户的身份终于浮出水面,...[详细]
-
 你错了! 写数据报告,最怕听见这三个字。特别是新同学,听到这三字简直如雷贯耳被吓得不知所措。其实,并非所有的错误都是我们的问题。今天我们就系统讲解下,数据分析报告常见的错误,和其中真正应该警觉的部分。...[详细]
-
云计算核心技术Docker教程:Python镜像使用 Compose 在本地开发
 在本节中,我们将创建一个Compose 文件以使用单个命令启动我们的 python-docker 和 MySQL 数据库。我们还将设置 Compose 文件以python-docker-dev在调试模...[详细]
-
标签: DeepSeek V3.2 Speciale Gemini-3.0-Pro
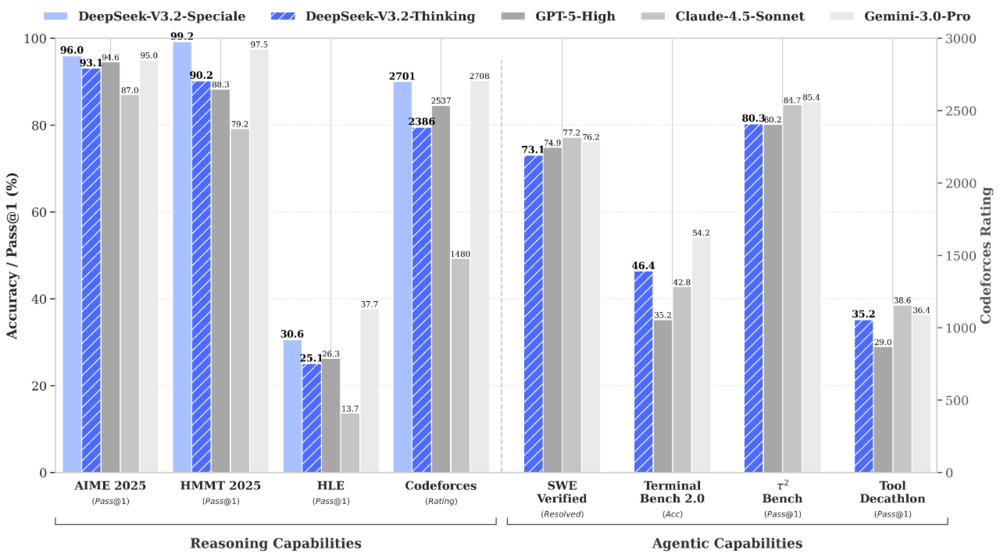 云梦级12月1日云梦级消息,据DeepSeek官方公众号公布,两个月前,实验性的 DeepSeek-V3.2-Exp发布,收到了众多热心用户反馈的对比测试结果。目前未发现 V3.2-Exp 在任何特定...[详细]
- https://www.jusoen.com/addreng.asp?p1=谷歌搜索留痕【tg:seogoogle987】KVq
- https://www.kyuhoshi.com/?s=谷歌搜索留痕【tg:seogoogle987】,9Fv
- https://www.samen-maier.at/search/谷歌搜索留痕【tg:seogoogle987】,SM0
- https://www.supersauna.de/catalogsearch/result/?q=谷歌搜索留痕【tg:seogoogle987】,OKw
- https://www.paxnet.co.kr/search/jongmok?kwd=谷歌搜索留痕【tg:seogoogle987】Ml3
- https://www.lauben.com/de/?s=谷歌搜索留痕【tg:seogoogle987】,CKi
- https://www.skicheck.at/en/?action=CHECK&s=谷歌搜索留痕【tg:seogoogle987】,qsV
- https://www.unclefossil.com/search/谷歌搜索留痕【tg:seogoogle987】gad_source=1&gclid=Cj0KCQjw_-GxBhC1ARIsADGgDjsNKplUXa2F6YGlHBK2sHDQ88cgsJBb05DyO99TV9jNq_cT0kGMqyQaAgHQEALw_wcB
- https://m.shoppinghow.kakao.com/m/search/q/谷歌搜索留痕【tg:seogoogle987】2Pm
- https://www.merchbar.com/search?q=谷歌搜索留痕【tg:seogoogle987】,PYl