标签: 小米 MiMo-V2-Flash 开源模型 混合滑动窗口
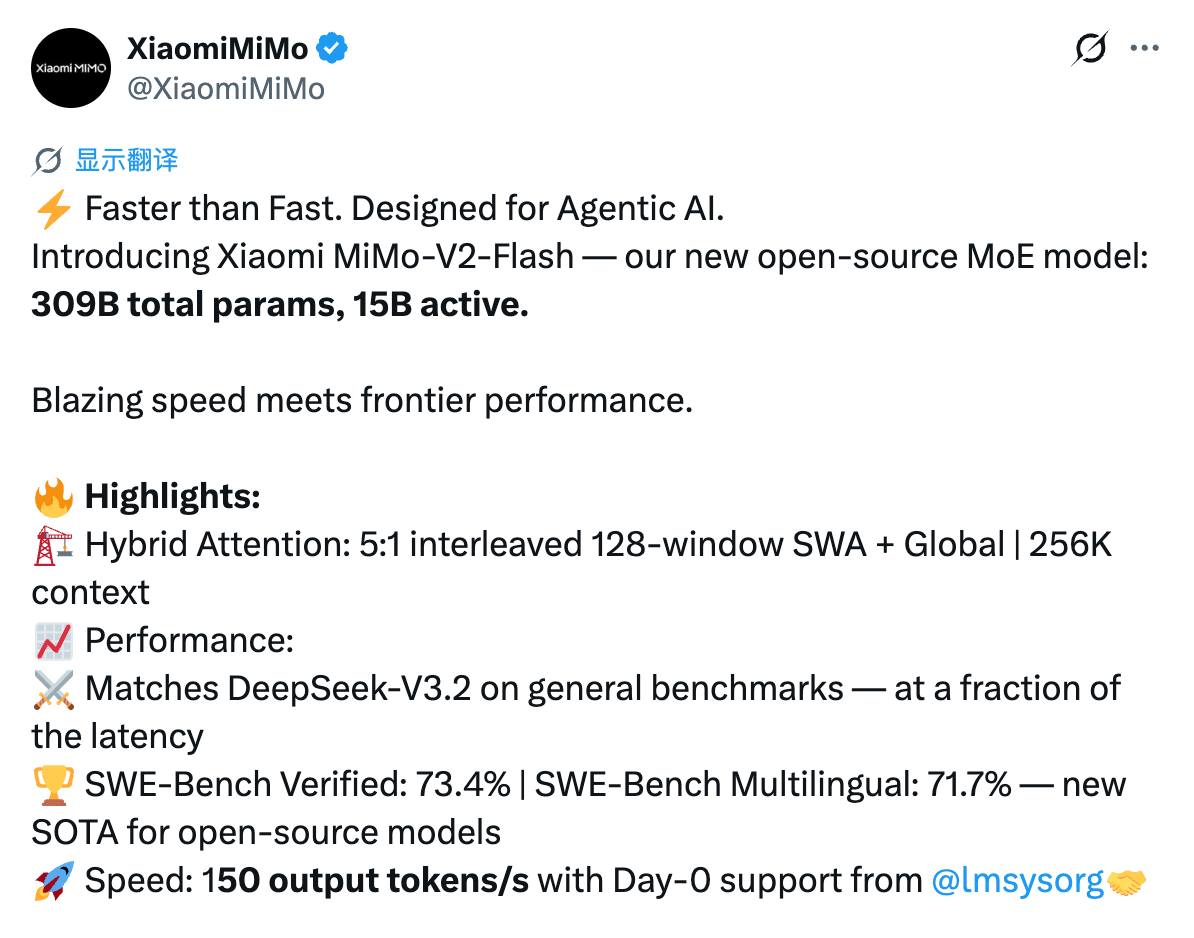
云梦级12月17日云梦级消息,据APPSO报道,刚刚,小米正式发布并开源新模型 MiMo-V2-Flash。MiMo-V2-Flash 总参数 3090 亿,活跃参数 150 亿,采用专家混合架构 (MoE),性能还能和 DeepSeek-V3.2、Kimi-K2 这些头部开源模型掰掰手腕。
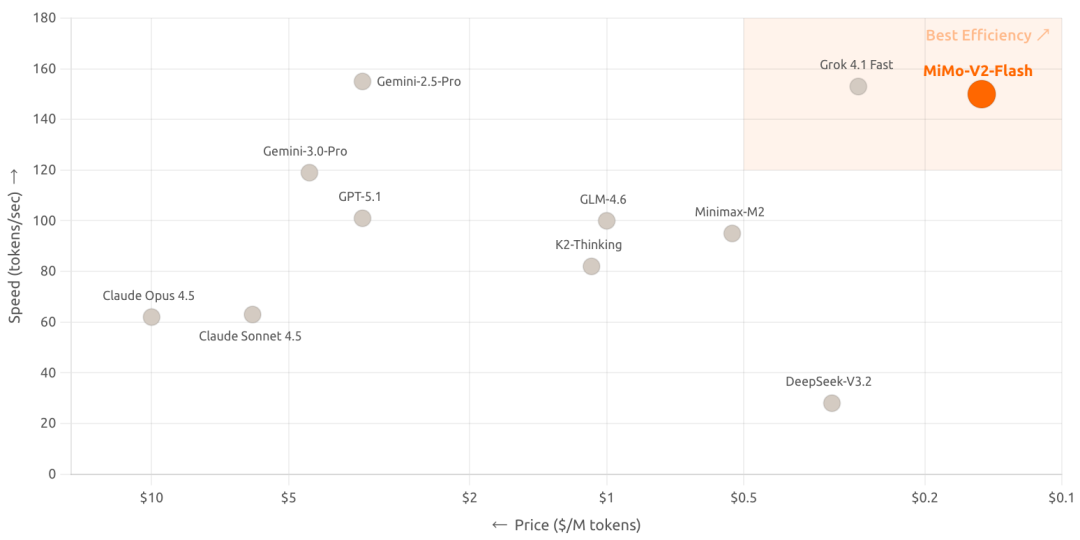
此外,MiMo-V2-Flash 采用 MIT 开源协议,基础版权重也已经在 Hugging Face 上发布。除去「开源」标签这一标签,新模型真正的杀手锏在于架构设计上的激进创新,把推理速度拉到了 150 tokens/秒,成本压到了每百万 token 输入 0.1 美元、输出 0.3 美元,主打一个超绝性价比。
根据官方体验页面信息,MiMo-V2-Flash 还支持深度思考和联网搜索功能,既能对话聊天,也能在需要实时数据、最新动态或资料核对的场景里派上用场。
基准测试成绩显示,AIME 2025 数学竞赛和 GPQA-Diamond 科学知识: 测试中,MiMo-V2-Flash 都排在开源模型前两名。编程能力更是亮眼,SWE-bench Verified 得分 73.4%,超越所有开源模型,直逼 GPT-5-High。而这个测试是让 AI 去修真实世界的软件 bug,73.4% 的成功率也意味着它能搞定大部分实际编程问题。
在多语言编程基准测试 SWE-Bench Multilingual 里,MiMo-V2-Flash 的解决率为 71.7%。转看智能体任小米务,MiMo-V2-Flash 在τ²-Bench 分类得分中,通信类 95.3 分,零售类 79.5 分,航空类 66.0 分,BrowseComp 搜索代理得分 45.4,启用上下文管理后直接飙到 58.3。
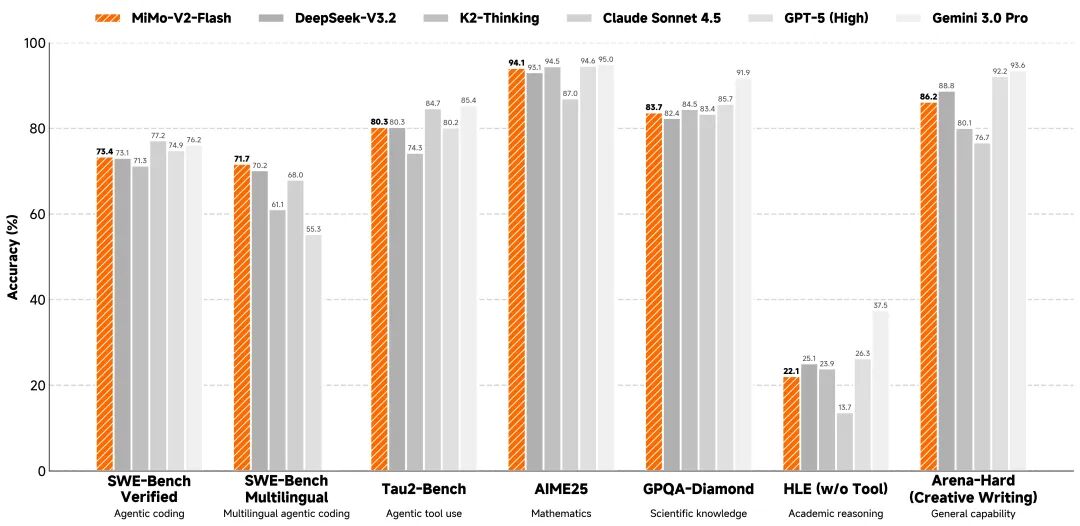
这些数据说明,MiMo-V2-Flash 不仅会写代码,还能真正理解复杂任务逻辑,执行多轮智能体交互。
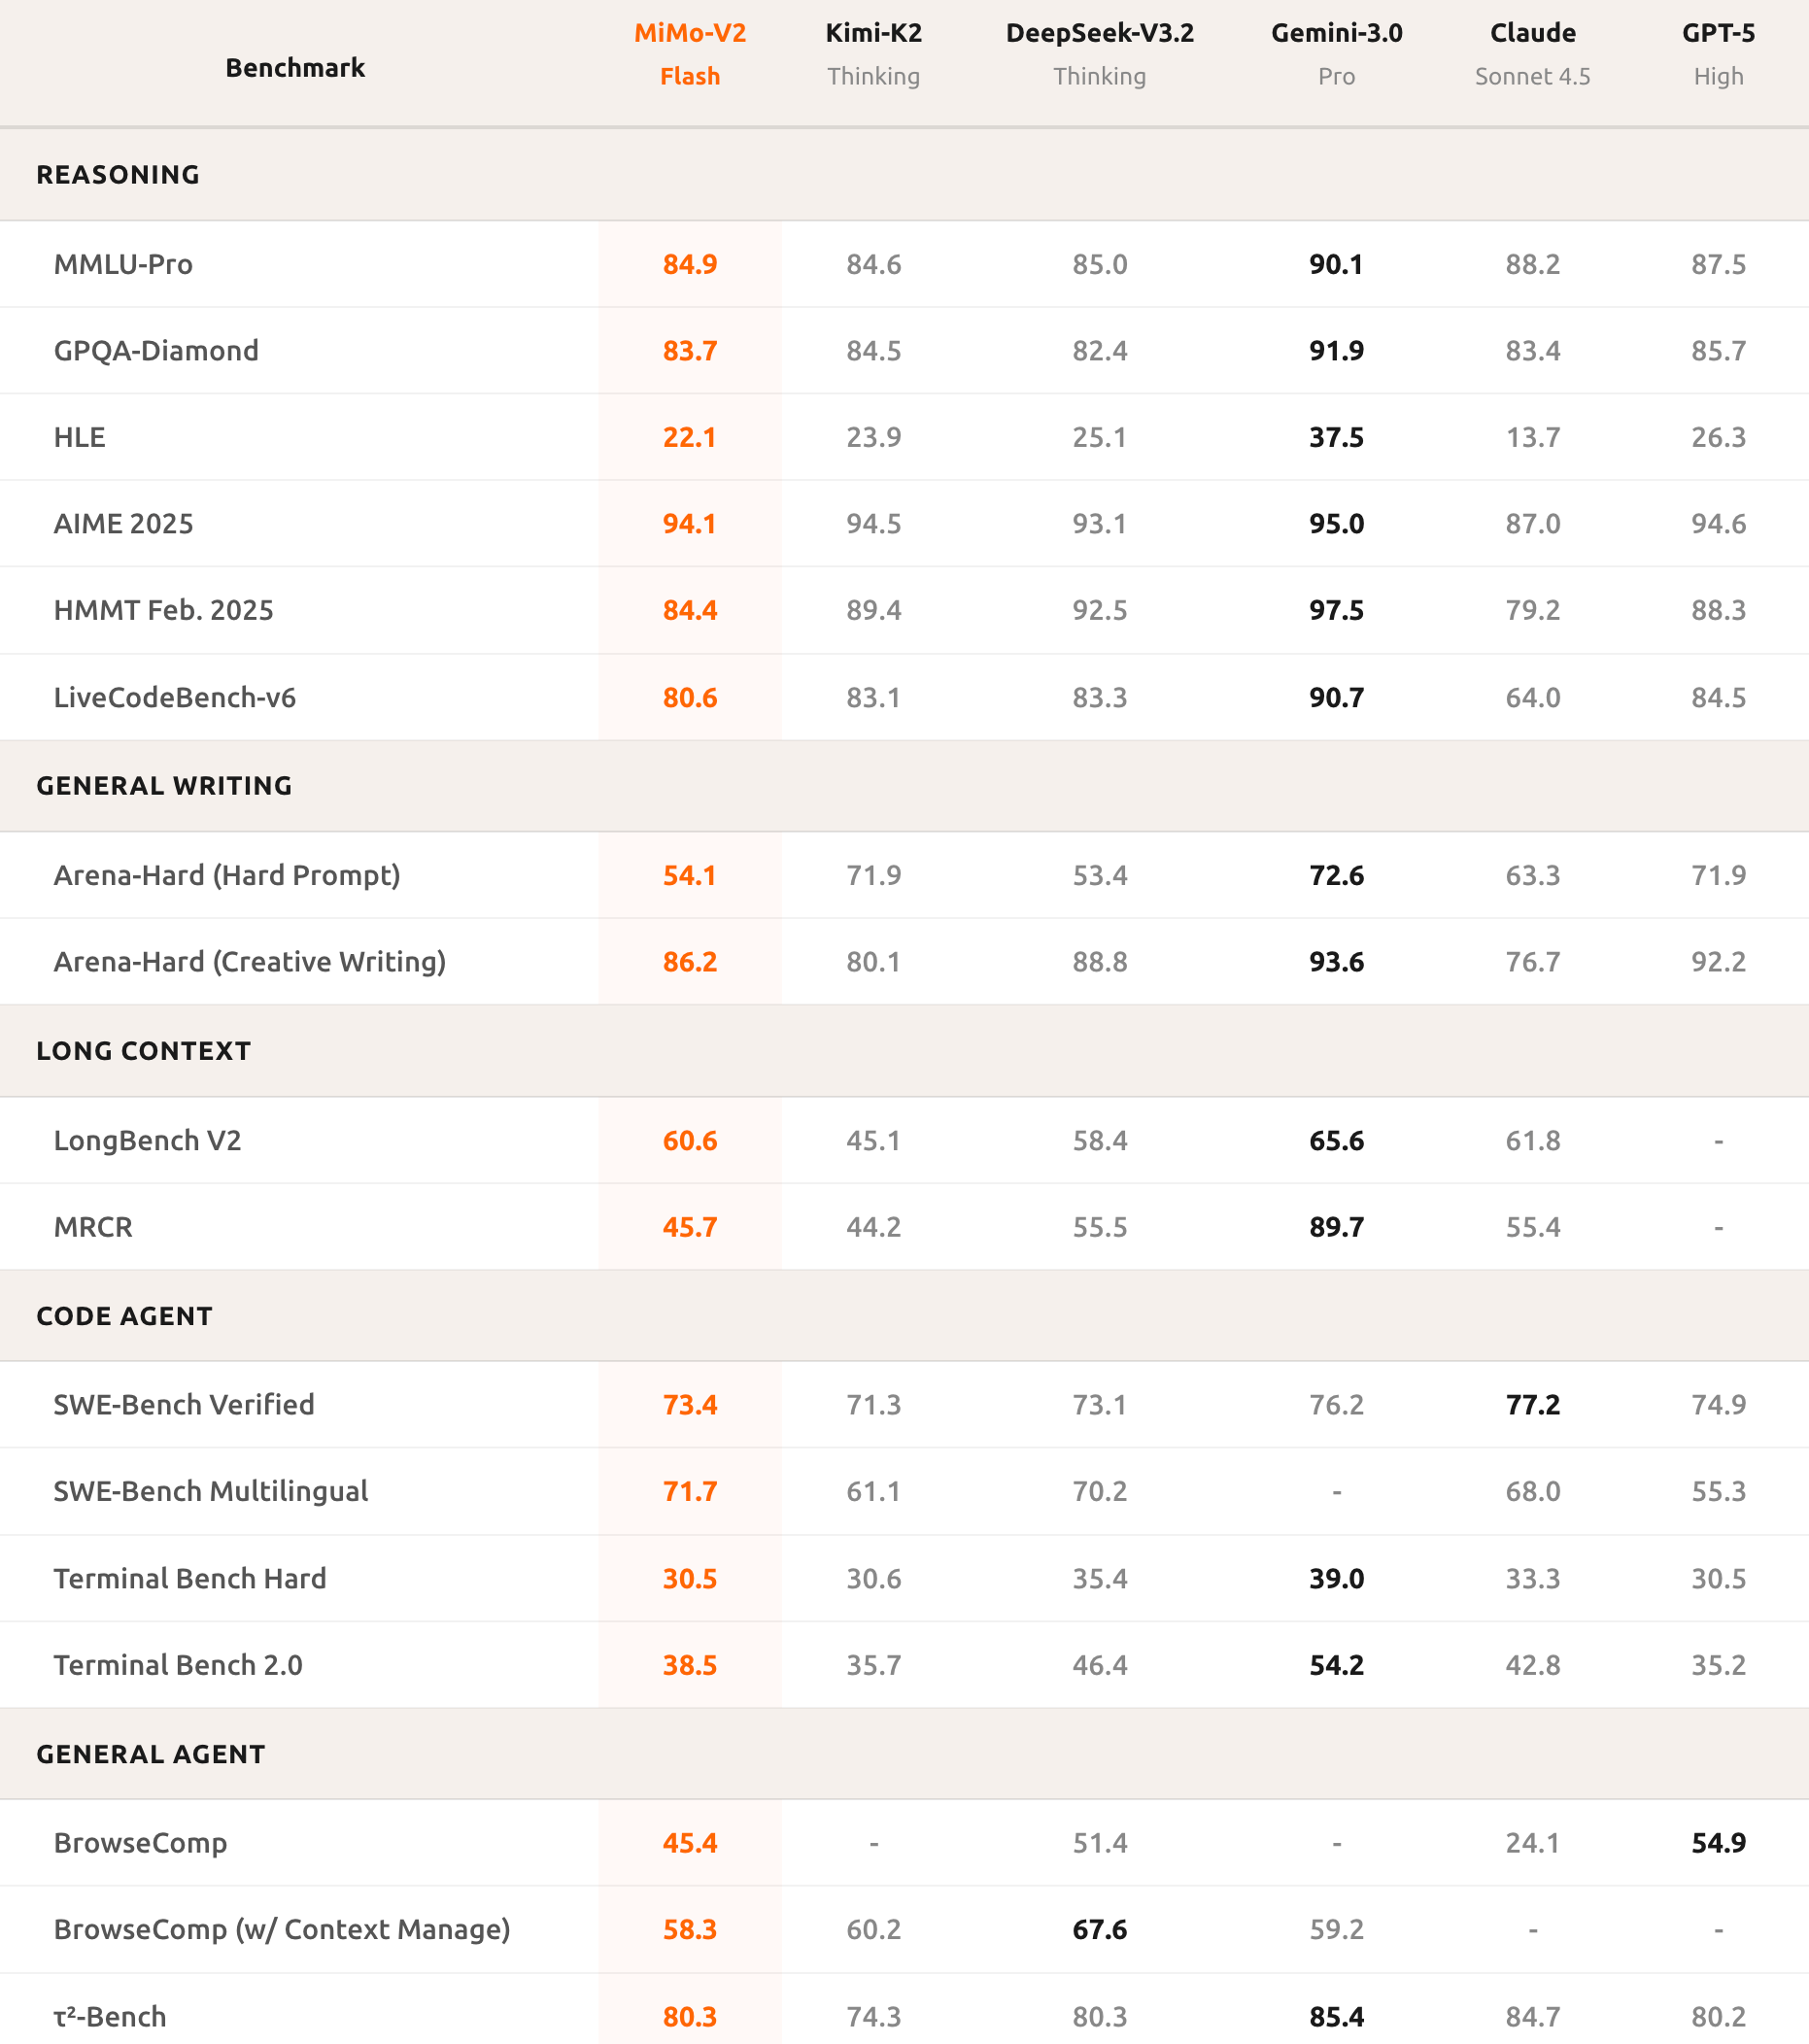
更重要的是,写作质量也接近顶级闭源模型,这意味着 MiMo-V2-Flash 不只是个工具,还能当个靠谱的日 M常助手。
MiMo-V2-Flash 在保持长文本性能的同时,还降低了成本,究其原因,离不开两项核心技术创新。
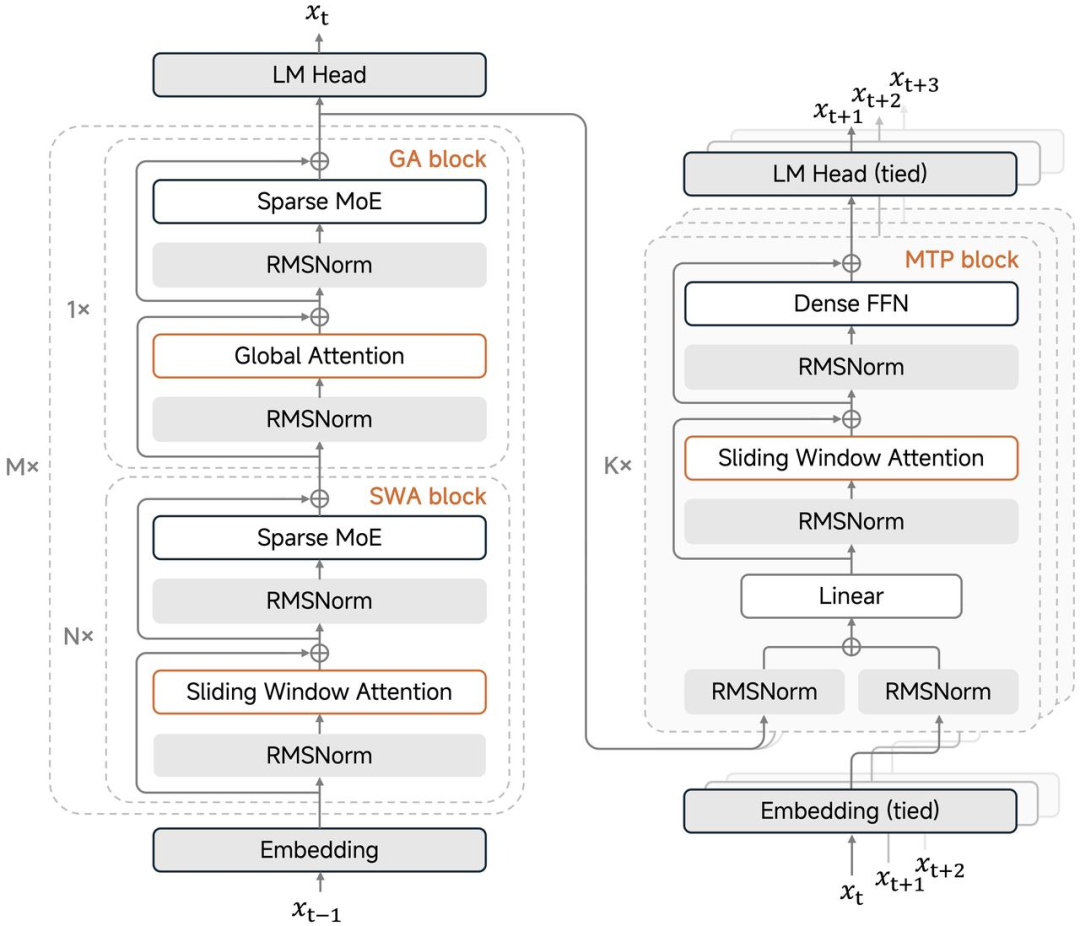
混合滑动窗口注意力机制:传统大模型处理长文本时,全局注意力机制会导致计算量二次爆炸,存储中间结果的 KV 缓存也跟着飙升。
小米这次采用了 5 比 1 的激进比例,5 层滑动窗口注意力搭配 1 层全局注意力交替使用,滑动窗口只看 128 个 token。
这种设计让 KV 缓存存储量直接减少了近 6 倍,但长文本能力却没iM打折扣,最长支持 256k 上下文窗口。
且模型即使在这么激进的窗口设置下,照样能稳住长文本性能。
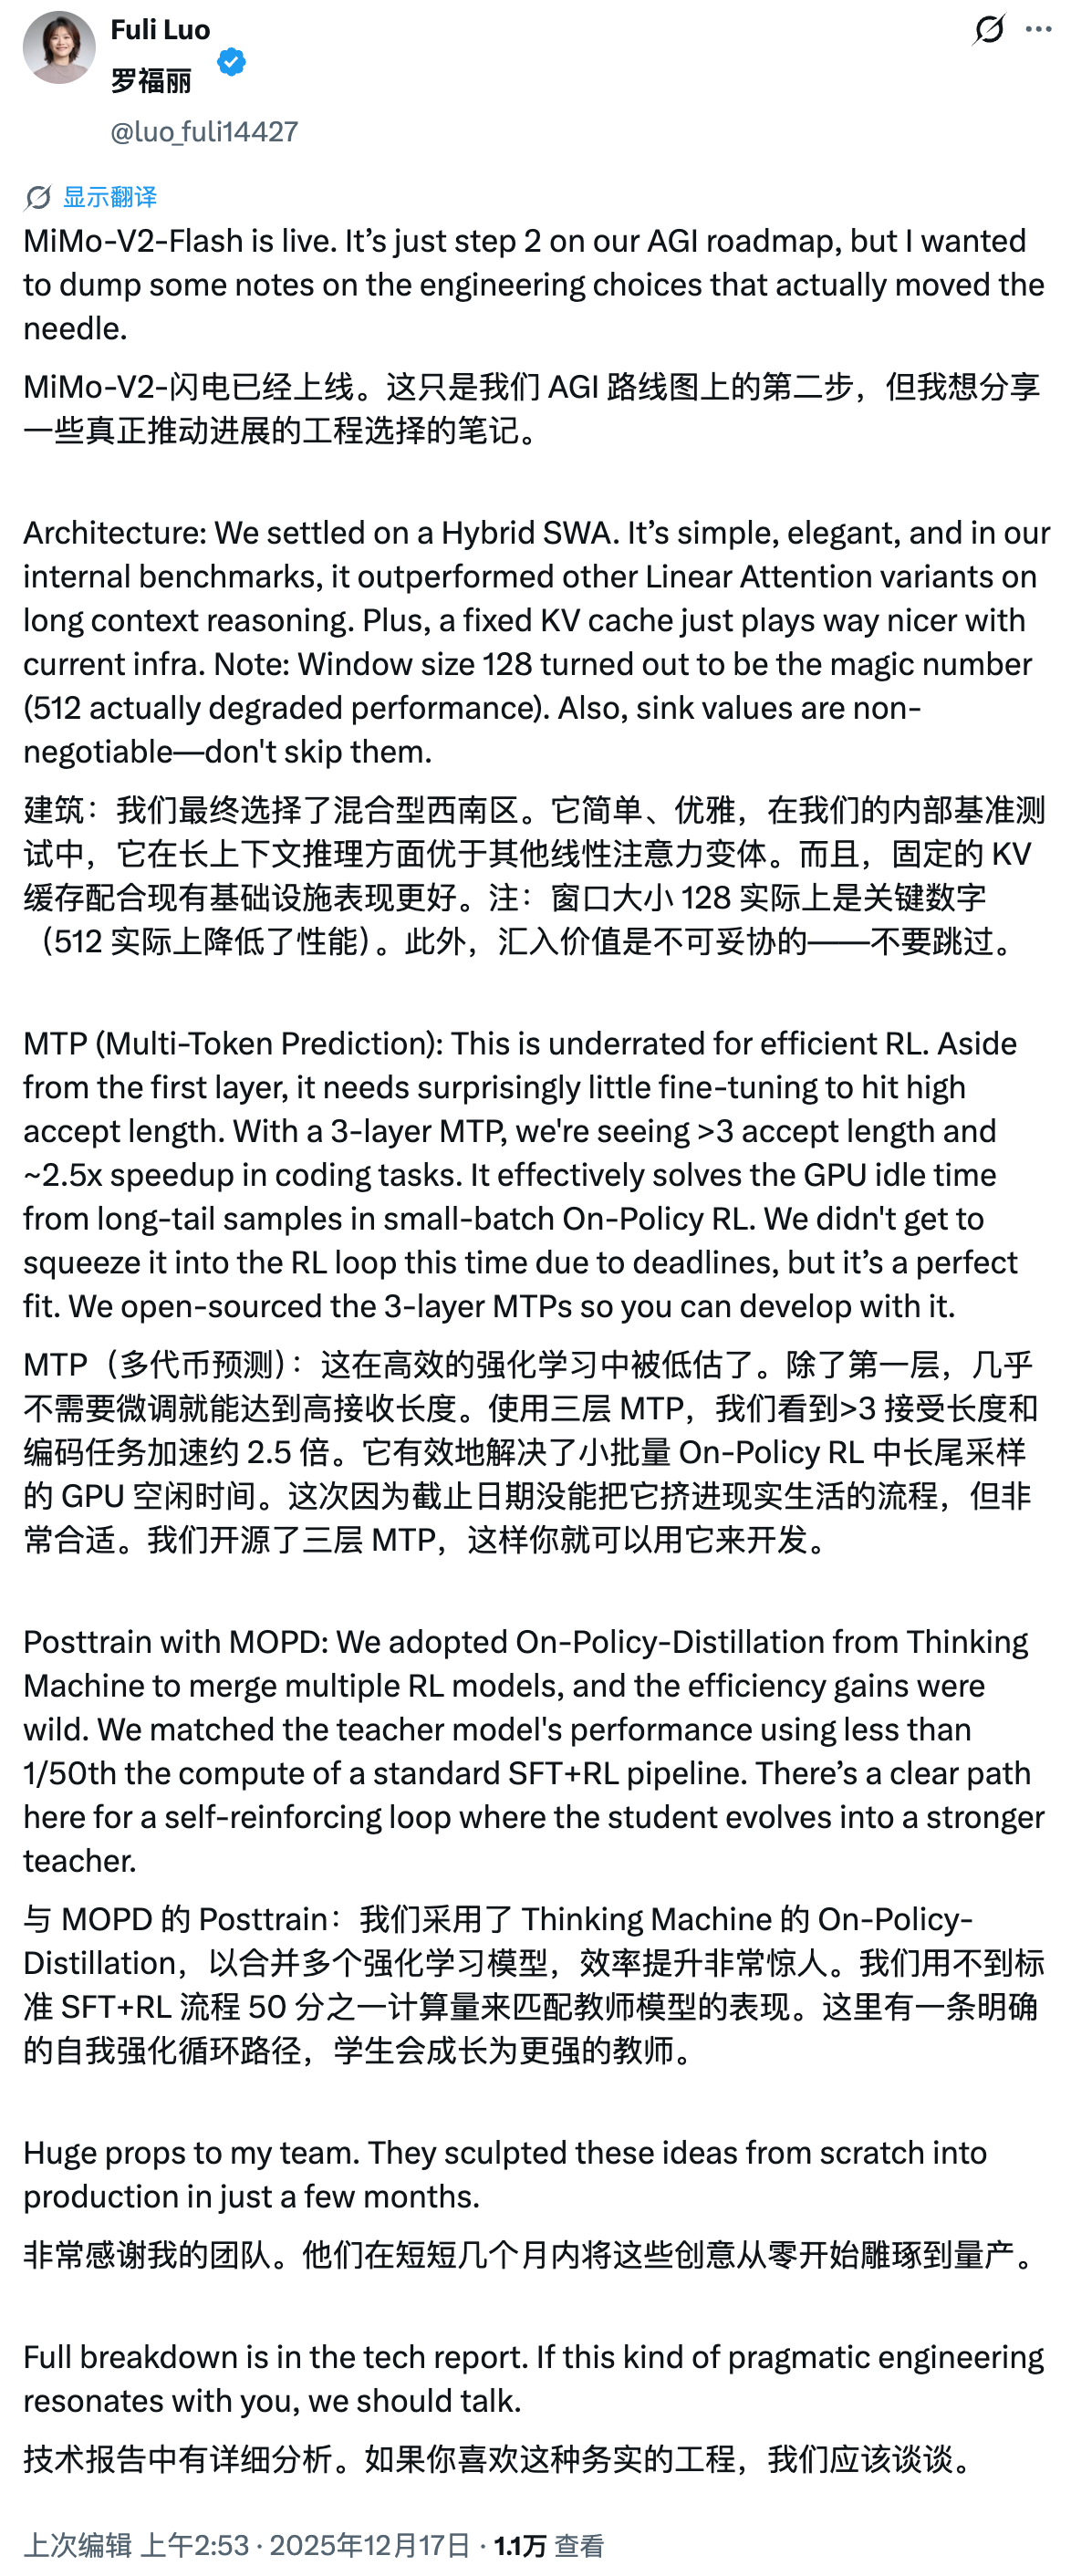
对此,罗福莉在社交平台上特别指出一个反直觉的发现:窗口大小 128 是「最佳甜点值」。实验证明,盲目扩大窗口(如增至 512)反而会导致性能下降。同时她强调,在实施该机制时,sink values 是维持性能的关键,绝不可省略。
另一个黑科技是轻量级多 Token 预测 (MTP)。
传统模型生成文本时一次只能吐一o-个 token,就像打字员一个字一个字敲。MiMo-V2-Flash 通过原生集成的 MTP 模块,能并行预测多个 token,一次性猜出接下来好几个 token。
实测平均能接受 2.8 到 3.6 个 token,推理速度直接提升 2 到 2.6 倍,不仅在推理时管用,训练阶段也能加速采样,减少 GPU 空转,属于一箭双雕。
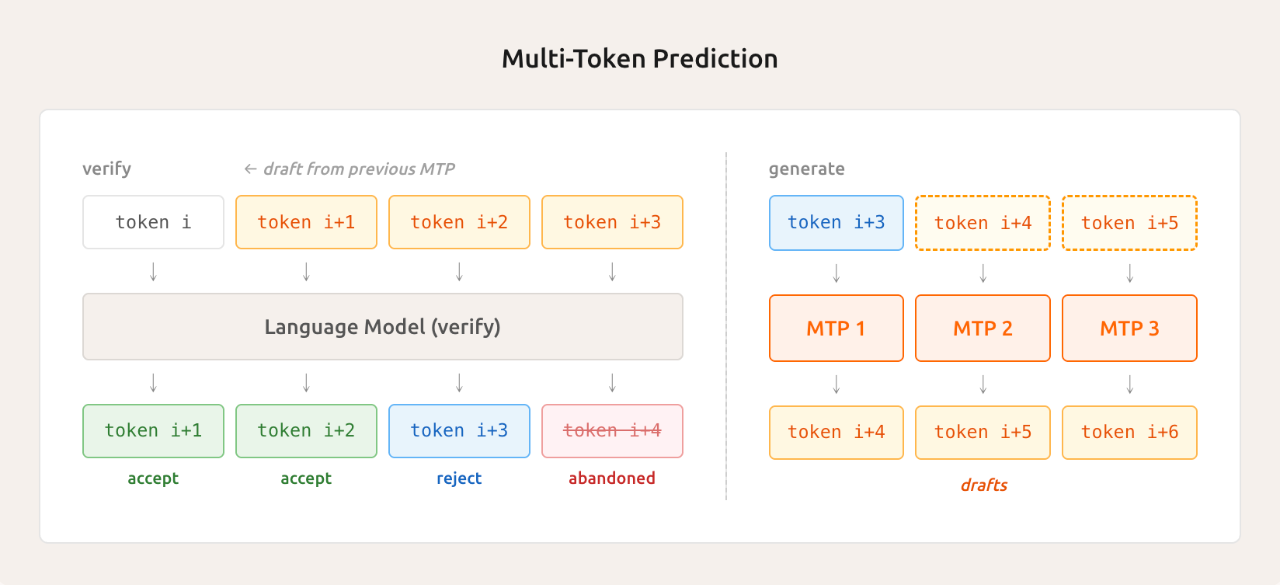
罗福莉提到,在三层 MTP 设置下,他们观察到平均接受长度超过 3,编码任务速度提升约 2.5 倍。它V2有效解决了小批量 On-Policy 强化学习中「长尾样本」带来的 GPU 空闲时间浪费问题。
啥叫长尾样本?就是那些特别难、特别慢的任务,拖着其他任务一起等,GPU 就在那干瞪眼。MTP 把这个问题给解了,极大提高了效率。
不过罗福莉也坦诚,这次因为时间紧迫没能把 MTP 完整集成进 RL 训练循环,但它与该流程高度契合。小米已经把三层 MTP 开源了,方便大家在自己的项目中使用与开发。
算力只用 1/50,性能-F如何不打折?
预训练阶段,新模型使用 FP8 混合精度,在 27 万亿 token 数据上完成训练,原生支持 32k 序列长度。
FP8 混合精度是一种压缩数值表示的技术,能在保持精度的同时减少显存占用和加速训练。这种训练方式在业界并不常见,需要对底层框架进行深度优化。
而在后训练阶段,小米整了个大活,提出了多教师在线策略蒸馏 (MOPD)。
传统的监督微调加强化学习管线,不仅训练不稳定,算力消耗还贼高。MOPDla 的思路是让学生模型在自己的策略分布上采样,然后由多个专家教师在每个 token 位置提供密集的奖励信号。
MOPD Architecture Diagram
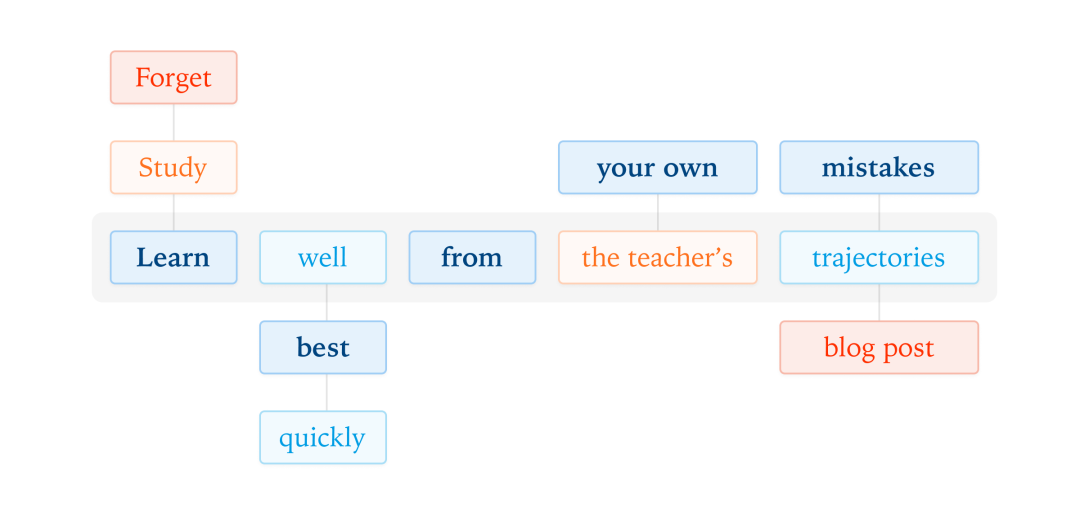
通俗点说就是,学生模型自己写作业,老师在每个字上都给评分,不用等写完整篇才打分。这样一来,学生模型能快速从教师那里学到精髓,而且训练过程稳定得多。
最夸张的是效率提升,MOPD 只需要传统方法 1/50 的算力,就能让学生模型达到教师性能峰值。这意sh味着小米能用更少的资源,更快地迭代模型。
而且 MOPD 支持灵活接入新教师,学生模型成长后还能反过来当教师,形成「教与学」的闭环自我进化。今天的学生,明天的老师,后天又能教出更强的学生,套娃玩法属实有点东西。
用罗福莉的话来说,他们借鉴 Thinking Machine 的 On-Policy Distillation 方法,将多个强化学习模型进行融合,结果带来了惊人的效率提升。这为构建一个自我强化循环系统 开奠定了基础,学生模型可以逐步进化,最终成为更强的教师模型。
On-Policy Distillation - Thinking Machines Lab
在智能体强化学习扩展上,小米 MiMo-V2-Flash 研究团队基于真实 GitHub issue 构建了超过 10 万个可验证任务,自动化流水线跑在 Kubernetes 集群上,并发能开 10000 多个 Pod,环境部署成功率 70%。
针对网页开发任务,还专门搞了个多模态源模验证器,通过录制视频而非静态截图来验证代码执行结果,直接减少视觉幻觉,确保功能正确。
对于开发者而言,MiMo-V2-Flash 能与 Claude Code、Cursor、Cline 等主流开发环境无缝配合,256k 的超长上下文窗口支持数百轮智能体交互与工具调用。
256k 是什么概念? 大概相当于一本中等篇幅的小说,或者几十页技术文档。这意味着开发者可以把 MiMo-V2-Flash 直接融入现有工作型 流,不需要额外适配,拿来就用。
小米还把所有推理代码贡献给了 SGLang,并在 LMSYS 博客分享了推理优化经验。
技术报告公开了完整模型细节,模型权重 (包括 MiMo-V2-Flash-Base) 在 Hugging Face 上以 MIT 许可协议发布。这种全面开源的态度,在国内大厂里属实少见。
目前 MiMo-V2-Flash 已经在 API Platform 限时免费开放,开发者可以直接上手体验。
(责任编辑:VIP 服务)
 马斯克AI编程神器发布!Grok Code Fast 1免费开放,92倍速度碾压全场
 标签: Keep Kaka 运动科技 健身APP
 机器人流程自动化的发展展望
 标签: 雅乐科技 Yalla 101OkeyYalla 中东社交游戏
 标签: Alphabet 谷歌云 YouTube Google
-
 云梦级3月24日云梦级消息,张雪峰公司苏州峰学蔚来教育科技有限公司今日发布讣告称,亲爱的张雪峰老师,因心源性猝死全力抢救无效,于2026年3月24日15时50分在苏州逝世。 全文如下: 讣告 我们怀着...[详细]
-
 云梦级5月18日云梦级消息,贾跃亭今日发视频宣布,法拉第未来近期完成了7000万美元(现汇率约合4.77亿元人民币)机构投资者募资,并将启动战略、产品技术&业务、财务、资本、AI体系五大变革。 贾跃亭...[详细]
-
 云梦级1月4日云梦级消息,针对网络上出现的关于“宇树科技A股上市绿色通道被叫停”的说法。宇树科技回应《科创板日报》称“该报道涉及我司上市工作相关动态情况的内容与事实情况不符,我司未涉及申请“绿色通道”...[详细]
-
 云梦级6月9日云梦级消息,据潇湘晨报报道,6月8日,钉钉副总裁、AI产品负责人马锐拉在个人公众号上发布题为《置身钉外》的文章,称他已于5月15日办完离职手续,正式告别三年阿里生涯,离开钉钉。在这篇文章...[详细]
-
 新浪科技讯 北京时间7月7日下午消息,Twitter(NYSE: TWTR)今日宣布,将于2021年7月22日美国股市收盘后(北京时间7月23日)发布2021年第二季度财报。 财报发布后,Twitte...[详细]
-
 云梦级10月30日云梦级消息,谷歌旗下视频平台 YouTube 周三向 TechCrunch 证实,公司正针对美国本土员工实施一项“自愿离职计划”,并提供离职补偿。 YouTube 首席执行官尼尔・莫...[详细]
-
标签: 华为 Mate80ProMax WWDC26 影石创新
 Hello,大家早上好,又是元气满满的一天,先来浏览新鲜的早报吧~ 【华为春季全场景新品发布会汇总】 3 月 23 日华为春季全场景新品发布会举行,带来 Mate 80 Pro Max 风驰版等多款手...[详细]
-
 撰文 | 曹双涛 编辑 | 杨博丞 题图 | IC Photo “以前送外卖是挑单,今年是求单;以前担心送不完、怕超时,现在即使到了午晚餐高峰,手机也安静得像块砖;以前社媒平台上动辄宣传‘单王’月赚两...[详细]
-
 云梦级4月23日云梦级消息,香港证监会与普华永道香港达成协议,据此,普华永道香港同意预留10亿港元,以向中国恒大集团的合资格独立少数股东作出赔偿。 于2019财政年度及2020财政年度,普华永道香港是...[详细]
-
 云梦级7月6日云梦级消息,人工智能(AI)顶会 ICML(国际机器学习大会)公布了 2026 年度奖项,包括杰出论文奖(Outstanding Paper Award)、杰出立场论文奖(Outstan...[详细]